monitoraggio dell'uptime minimale e self-hosted_
Testo semplice, monospace, chiaro e scuro. Un container per l'hub, agent leggeri per controllare da ogni località che ti interessa. Open source, regge migliaia di monitor su una piccola VPS.
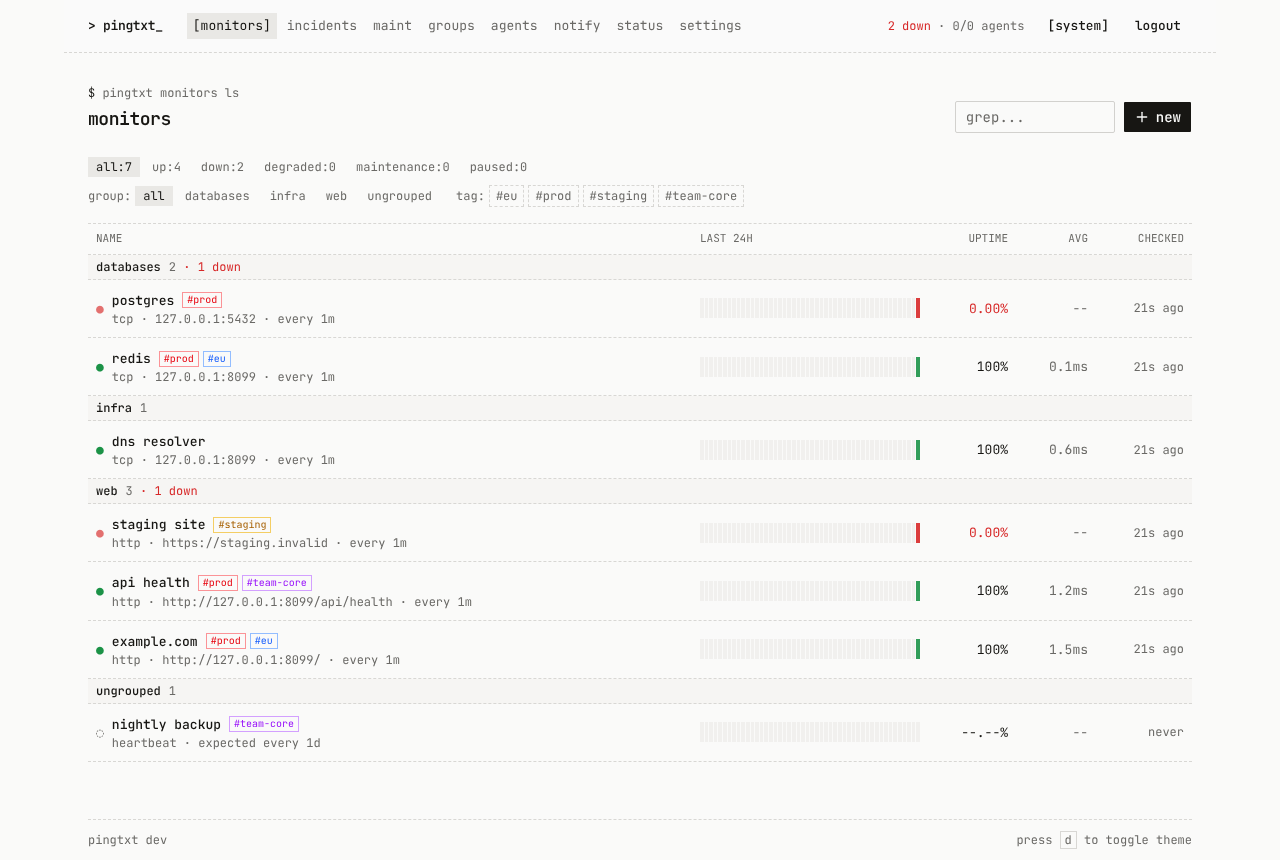
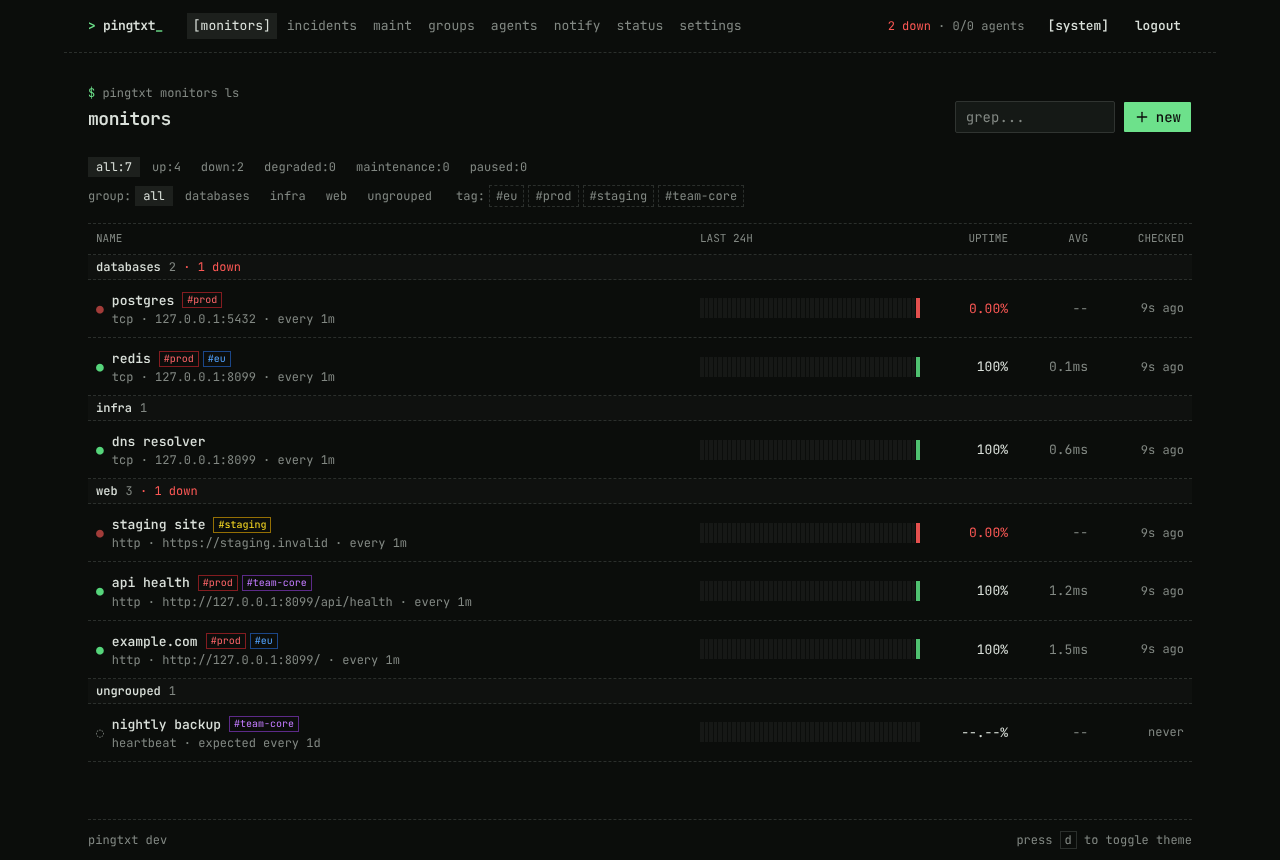
──funzioni
+ un solo container
API in Go, scheduler, SQLite e interfaccia web in un'immagine di ~25 MB. Nessun runtime Node; PostgreSQL o MariaDB solo se li vuoi.
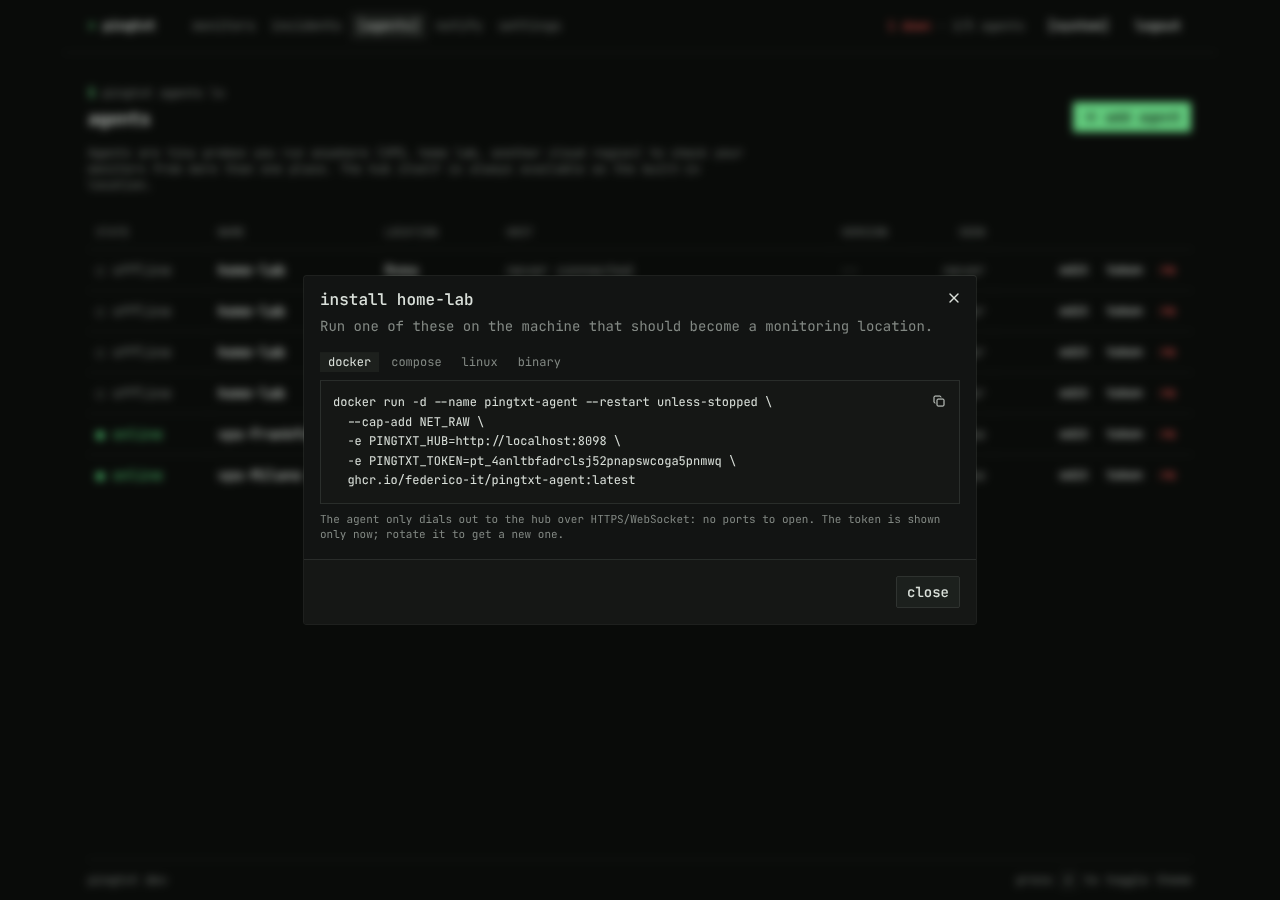
+ agent in più località
Un binario statico di ~8 MB che apre solo connessioni in uscita via WebSocket. Nessuna porta aperta, funziona dietro NAT. Si installa con un comando.
+ stato a maggioranza
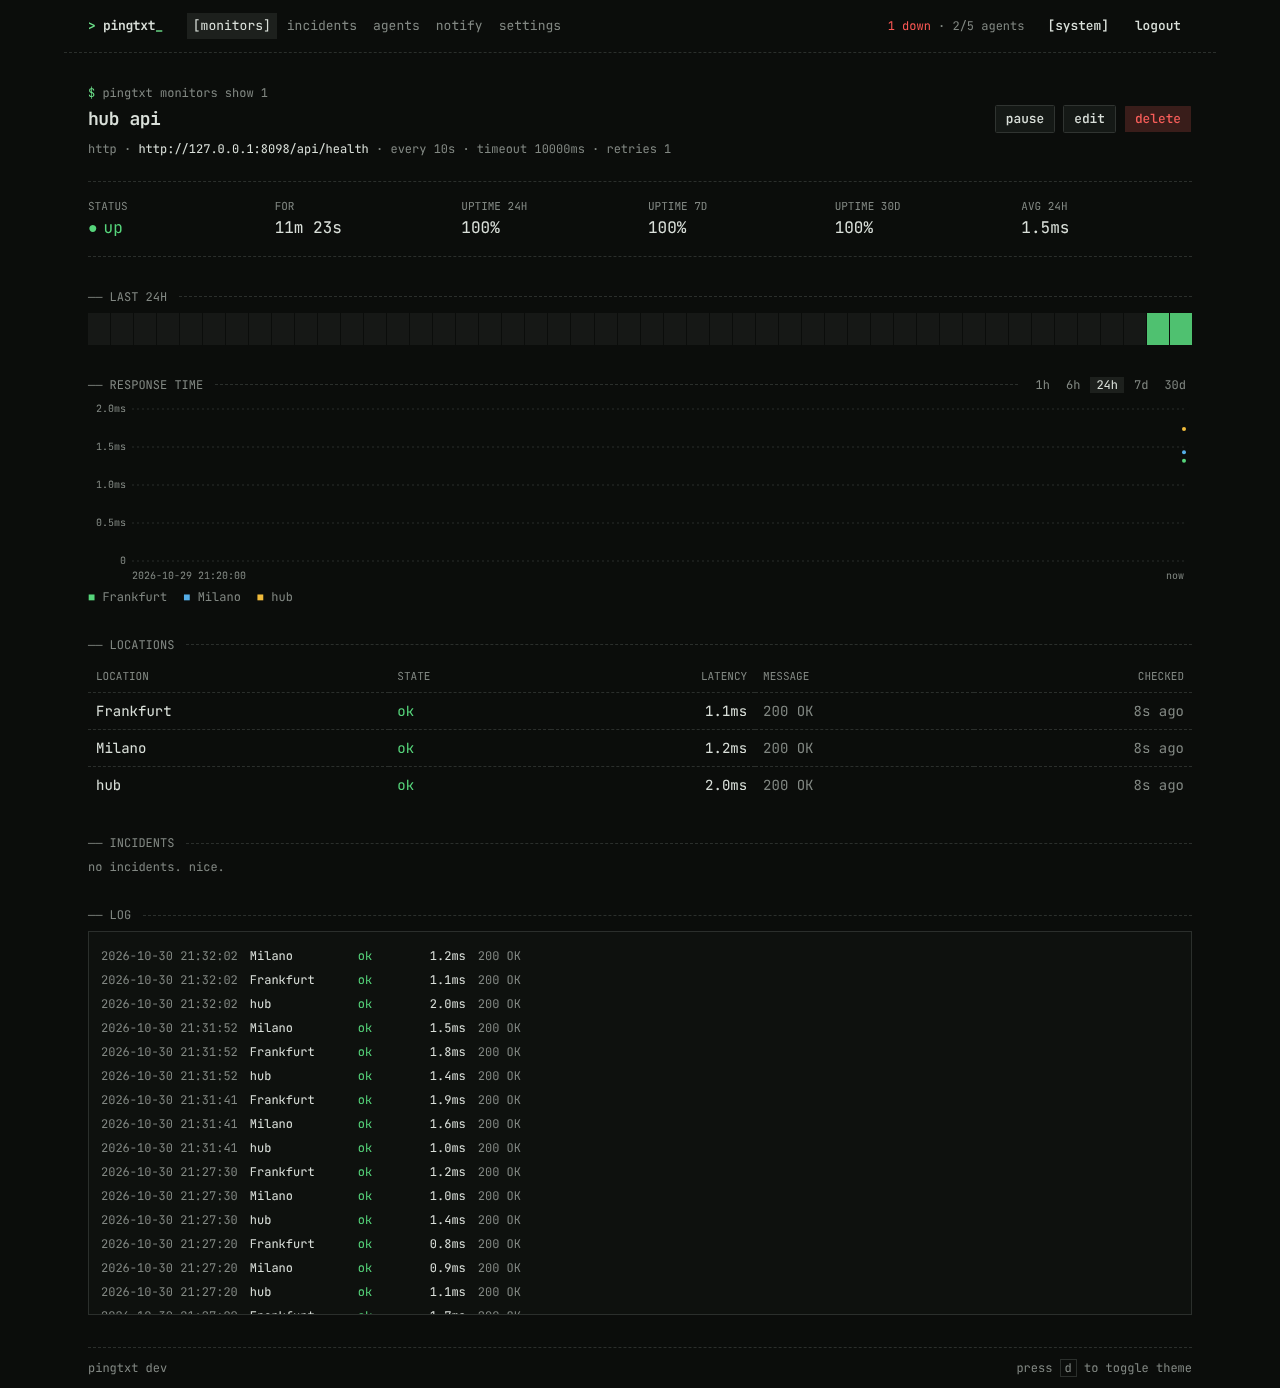
Down quando fallisce la maggior parte delle località online, degradato dal 35% (soglia a tua scelta). Tempo di risposta per località.
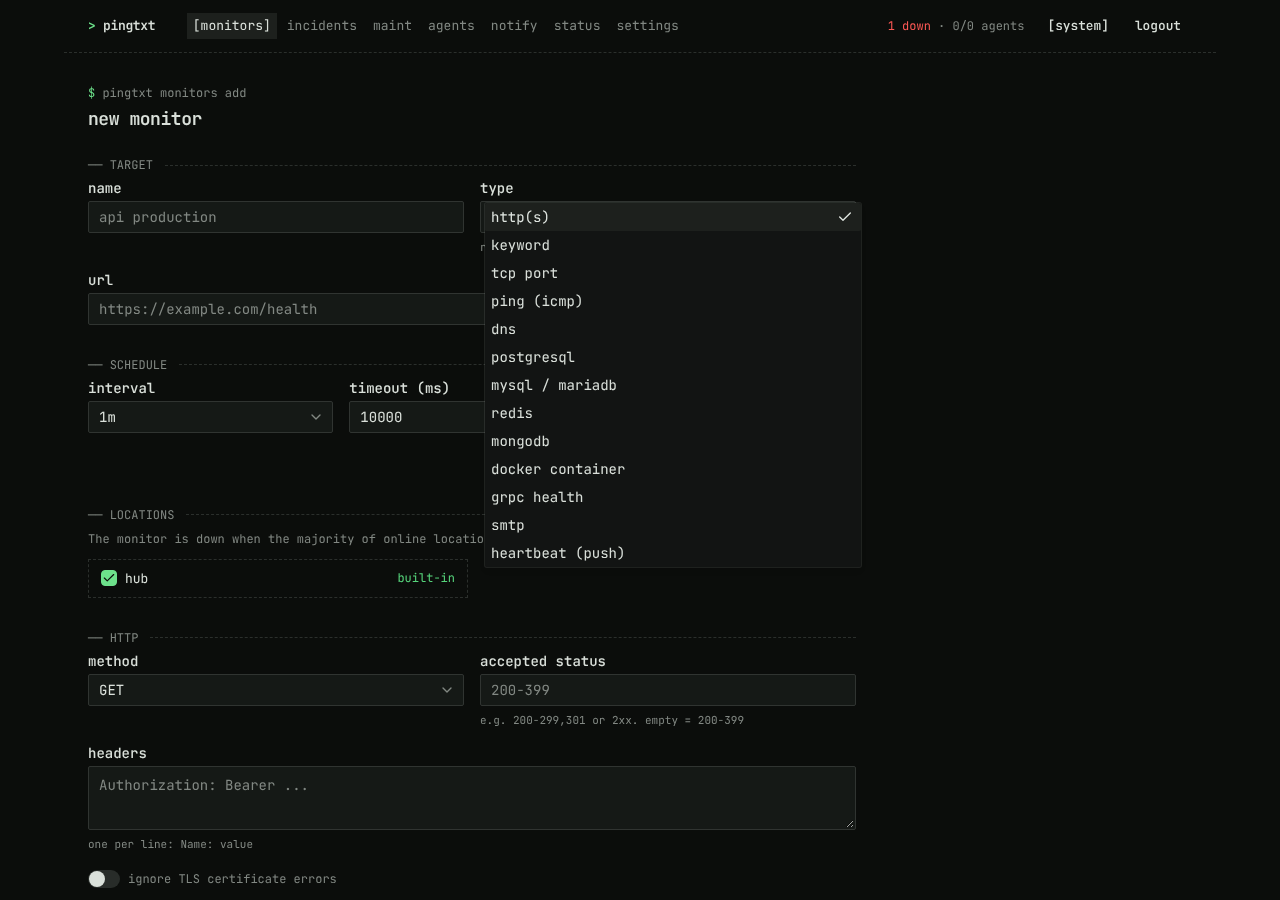
+ tanti tipi di controllo
HTTP(S), parola chiave, TCP, ping ICMP, DNS, PostgreSQL, MySQL, Redis, MongoDB, Docker, gRPC health, SMTP, server MCP e heartbeat.
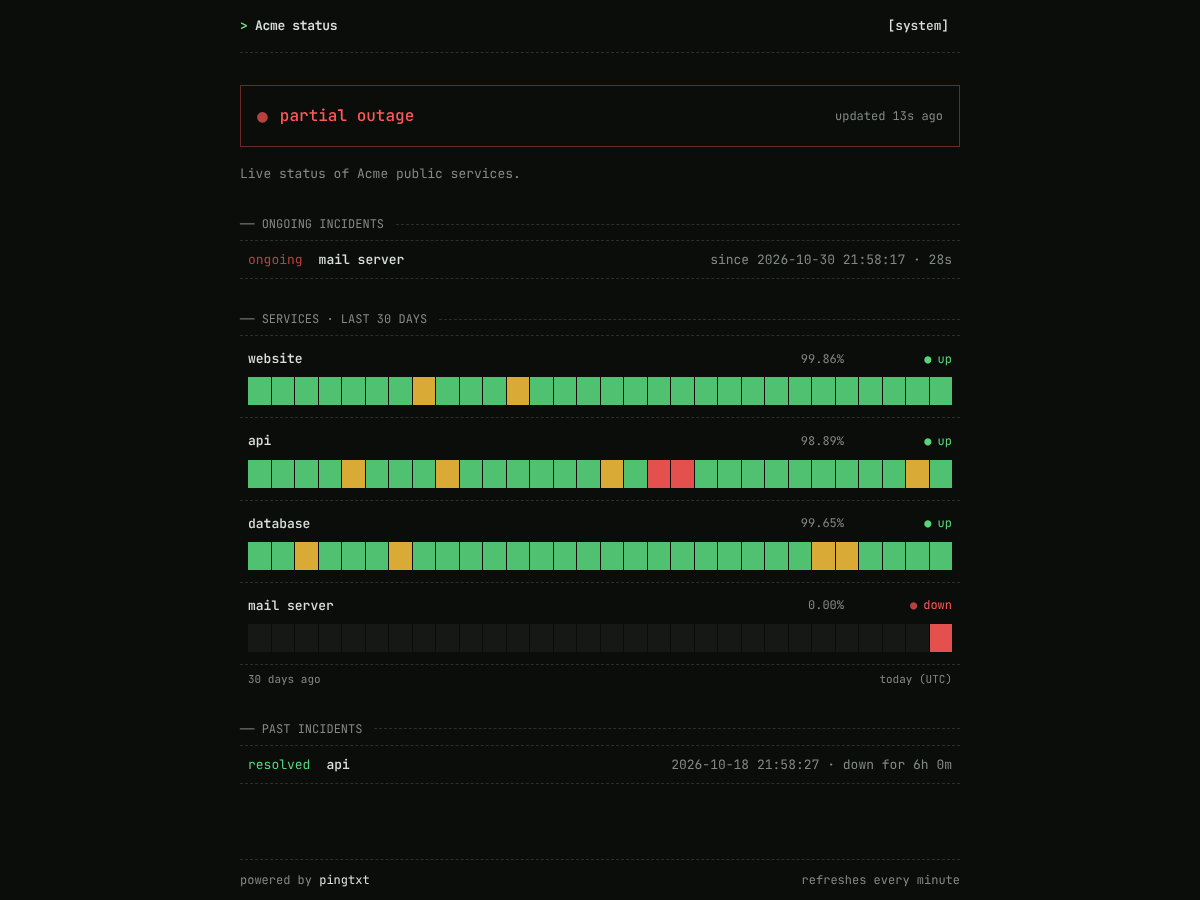
+ status page
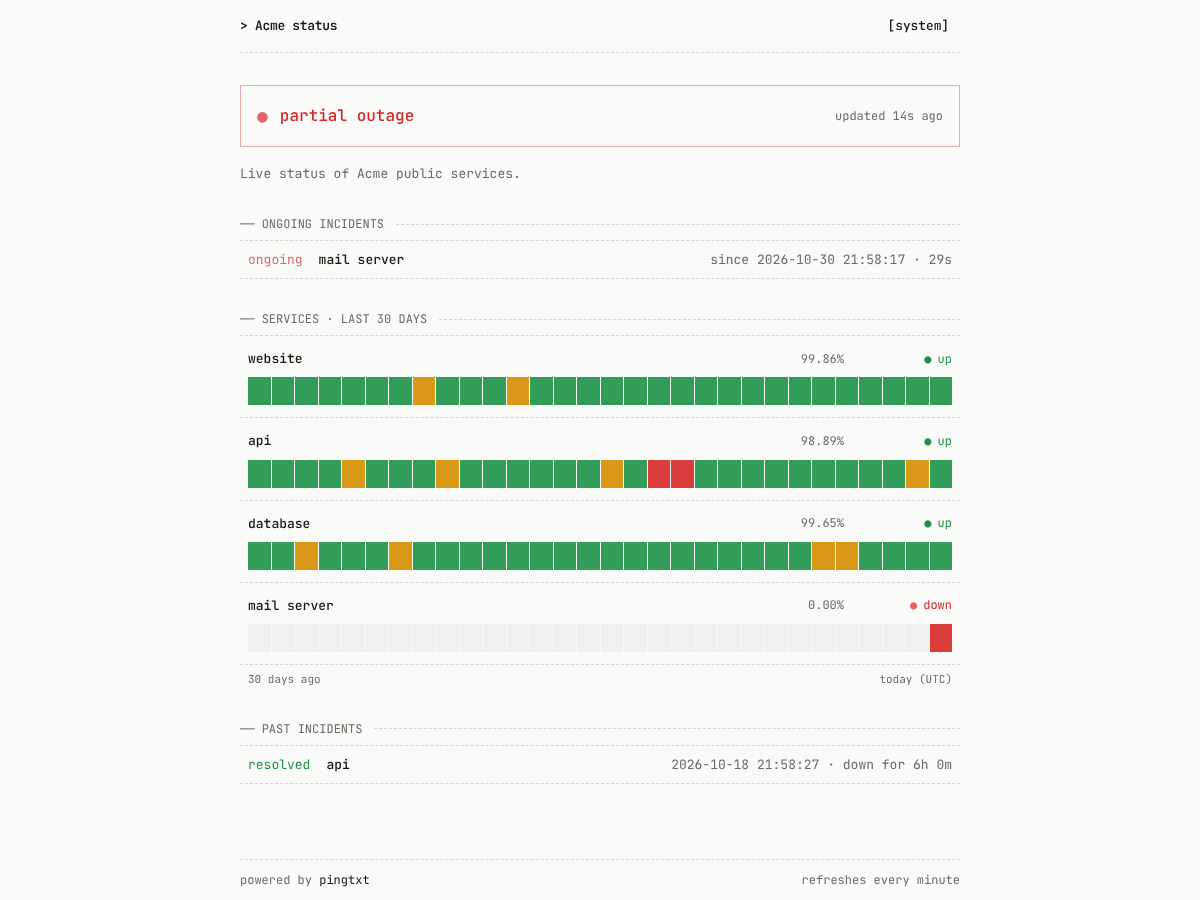
Pagine pubbliche con i monitor o i gruppi che scegli, 90 giorni di storico dell'uptime e incidenti con aggiornamenti scritti. Iscritti via email, domini personalizzati.
+ finestre di manutenzione
Singole o ricorrenti, in qualsiasi fuso orario, per monitor, gruppi o tag. Nessun avviso, non contano nell'uptime.
+ scadenza certificati + domini
Avvisi sui certificati TLS e sulla registrazione dei domini (RDAP, con WHOIS come riserva) con le soglie che decidi tu.
+ notifiche
Webhook, Discord, Slack, Telegram, ntfy ed email (SMTP). Prova ogni canale prima di salvarlo. Report via email settimanali o mensili per gruppo.
+ gruppi e tag
Sezioni nella dashboard e nelle status page, tag colorati, filtri. Selezioni per gruppo o tag ovunque.
+ accesso come preferisci
Password + TOTP, GitHub, Google o qualsiasi provider OpenID Connect. Token API personali, in sola lettura o lettura+scrittura.
+ prometheus + mcp
/metrics per Prometheus e un server MCP, così Claude e altri assistenti AI possono controllare lo stato e gestire i monitor.
+ agent che si aggiornano da soli
Aggiorni l'hub e gli agent si aggiornano da soli quando si ricollegano, con checksum verificato e ritorno alla versione precedente se qualcosa va storto.
──screenshots
──installazione
1. avvia l'hub
Salvalo come docker-compose.yml ed esegui docker compose up -d. Apri http://localhost:8090 e crea l'account admin.
services:pingtxt:image: ghcr.io/federico-it/pingtxt:latestrestart: unless-stoppedports:- "8090:8090"volumes:- ./data:/data
docker run -d --name pingtxt --restart unless-stopped \-p 8090:8090 -v ./data:/data \ghcr.io/federico-it/pingtxt:latest
2. aggiungi località (facoltativo)
L'hub controlla dal posto in cui gira. Per altre località avvia un agent dove vuoi: è lui a collegarsi all'hub, quindi non c'è niente da esporre.
# nell'interfaccia: agent → aggiungi agent, poi sulla macchina remota:docker run -d --name pingtxt-agent --restart unless-stopped --cap-add NET_RAW \-e PINGTXT_HUB=https://status.example.com -e PINGTXT_TOKEN=pt_xxx \-v pingtxt-agent:/data ghcr.io/federico-it/pingtxt-agent:latest# oppure Linux + systemd, binario scaricato dal tuo hubcurl -fsSL https://status.example.com/install-agent.sh | sudo sh -s -- \--hub https://status.example.com --token pt_xxx
Tutto il resto (URL pubblico, provider di accesso, notifiche, conservazione dei dati) si imposta nell'interfaccia web. Documentazione completa →
──come funziona
            ┌──────────────── hub container ────────────────┐
 browser ──>│  Go http server ─ /api/*  ─ SQLite/PG/MariaDB │
            │        │          /        ─ web UI            │
            │   scheduler ──> local probe ("hub" location)  │
            │        │                                       │
            └────────┼───────────────────────────────────────┘
                     │ lavori / risultati via WebSocket (si collega l'agent)
          ┌──────────┴──────────┐
     agent (Francoforte)   agent (home lab) ...
L'hub pianifica ogni controllo e lo manda agli agent; gli agent non hanno stato e si ricollegano con backoff. Hub e agent usano lo stesso codice Go per i controlli, quindi un controllo si comporta allo stesso modo da ogni località.